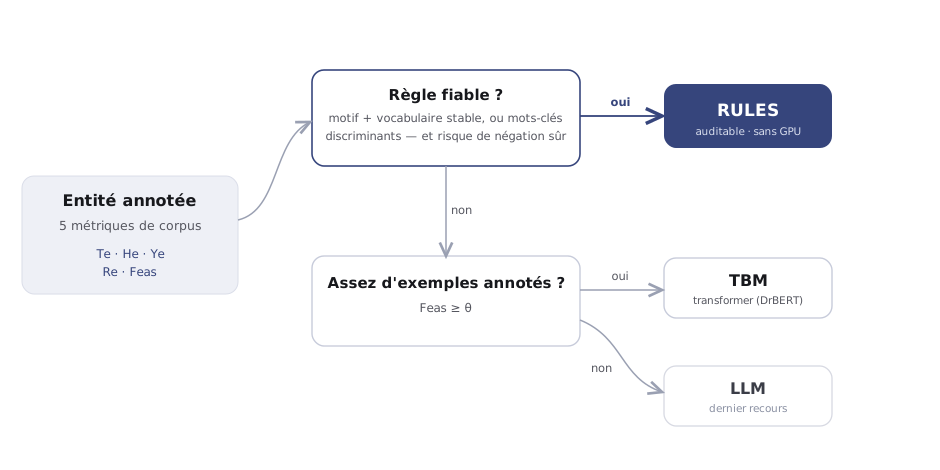
Je suis Clément Longeac. Je conçois DEMNE, un cadre de routage qui choisit, pour chaque type d'entité, la méthode la plus légère qui reste fiable : règles, transformer ou LLM. Sur une cohorte AP-HP jamais vue, il route 99,5 % des mentions vers des règles auditables à F1 0,941, là où un transformer affiné atteint 0,358.
Je suis étudiant en cinquième année à ESIEE Paris, spécialisation Data Science & IA, inscrit dans le parcours Tremplin Recherche de l'école — un programme conçu pour les étudiants visant une thèse plutôt qu'un stage classique en entreprise.
Mon travail consiste à rendre exploitable le texte clinique non structuré : extraire les biomarqueurs, les informations de stadification et les détails de traitement enfouis dans les comptes rendus d'oncologie français, là où les outils NLP génériques échouent systématiquement face au vocabulaire et à la structure documentaire du domaine.
En parallèle de mes études, je donne des cours de mathématiques et de physique-chimie via Complétude, et je prépare des candidatures pour une thèse CIFRE en IA biomédicale à Sorbonne Université.

Un pipeline hybride de reconnaissance d'entités nommées pour le texte clinique oncologique français.
des mentions routées vers les règles (cohorte AP-HP jamais vue, 411/413)
F1 des règles contre 0,358 pour un DrBERT affiné, mêmes entités
concordance de routage en leave-one-corpus-out
Les modèles NER génériques échouent nettement sur le texte clinique français : abréviations denses, mise en forme incohérente selon les établissements, et terminologie de biomarqueurs quasi absente des corpus d'entraînement généraux. DEMNE répond à ça par un pipeline en étages plutôt qu'un modèle unique — chaque étage traite ce qu'il fait le mieux, et n'escalade vers un modèle plus lourd que si nécessaire.
Le système est affiné sur DrBERT-7GB à travers trois corpus d'oncologie français distincts, et cible sept types d'entités biomarqueurs prioritaires utilisés dans les comptes rendus à visée thérapeutique.
Le pattern matching (regex, lexiques) capte à faible coût les entités à haute confiance et faible ambiguïté — dates, dosages, abréviations standard de biomarqueurs.
DrBERT-7GB, affiné sur trois corpus d'oncologie, traite les entités qui exigent une réelle compréhension sémantique et de domaine.
Les conflits résiduels et cas limites sont routés vers une passe LLM pour la désambiguïsation finale avant la sortie.
L'extraction d'entités cliniques sur des dossiers patients relève directement de la catégorie « haut risque » de l'EU AI Act. La conception en étages de DEMNE intègre les articles 12 et 14 dès le départ, pas après coup.
Chaque décision d'extraction est traçable jusqu'à l'étage (règles, transformer ou LLM) et au score de confiance qui l'a produite, ce qui permet une journalisation automatique pour l'audit.
Les sorties de l'arbitrage LLM sont signalées pour relecture clinicienne plutôt qu'acceptées silencieusement, gardant un humain dans la boucle sur les cas ambigus.
Application et validation de l'approche de routage DEMNE sur données hospitalières : extraction de biomarqueurs oncologiques (ER, PR, HER2, Ki67, FISH) à partir de comptes rendus cliniques français, et définition d'un parcours de déploiement clinique auditable et réaliste.
Conception de DEMNE, un pipeline hybride de NER clinique (règles / transformer / LLM) pour le texte d'oncologie français, piloté par cinq métriques de corpus formalisées — projet central du parcours Tremplin Recherche en vue des candidatures de thèse.
Construction d'une plateforme donnant aux patients cérébrolésés et à leurs ergothérapeutes un moyen structuré de comparer les outils numériques de compensation cognitive. Née en prototype Python/Streamlit au hackathon SN@SU (Sorbonne Université, avec des ergothérapeutes partenaires) ; en cadrage vers une refonte de production (FastAPI, PostgreSQL, Next.js) avec hébergement conforme HDS/RGPD et recherche sémantique pour l'appariement clinique.
Étudiant en cinquième année du cursus ingénieur en cinq ans d'ESIEE Paris, spécialisation Data Science & IA (DSIA).
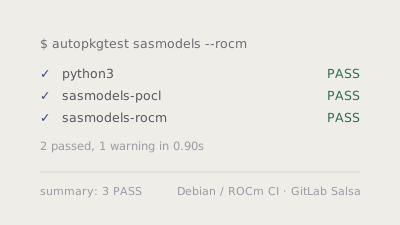
Développement d'autopkgtests en OpenCL pour la compatibilité GPU AMD (pyopencl, nabu, ufo-filters, pyvkfft) sur l'infrastructure Debian/ROCm via GitLab Salsa.
Cours de mathématiques et de physique-chimie à une dizaine d'élèves, du primaire jusqu'à la terminale, en parallèle de mes études d'ingénieur.
Le suivi écrit du travail sur DEMNE, à mesure qu'il avance vers la soumission.
Manuscrit détaillant le framework en cascade DEMNE, les cinq métriques de caractérisation de corpus utilisées pour la sélection de paradigme, et les résultats de calibration par recherche en grille sur trois corpus d'oncologie français.
Au-delà de DEMNE — des outils construits de bout en bout, du hackathon aux projets de données et d'infrastructure. Clique sur un projet pour le détail.

Un catalogue d'outils numériques de compensation cognitive pour les personnes cérébrolésées et leurs ergothérapeutes.

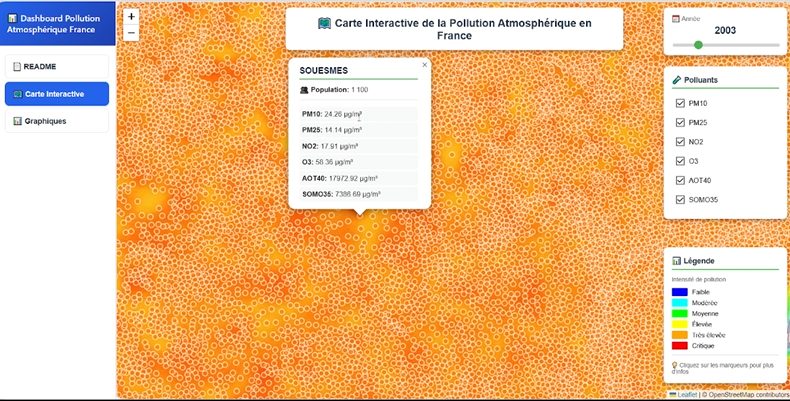
Un tableau de bord interactif reconstituant 15 ans de pollution atmosphérique de fond en France (2000–2015).
Reconnaissance de visages par CNN, d'abord sur images fixes puis en vidéo, avec augmentation de données et alignement des visages.
Un jeu d'aventure textuel en Python joué au terminal, à la conception orientée objet.
Une plateforme d'analyse de données culinaires : scraping, ETL et tableau de bord.
Scripts autopkgtest validant des logiciels scientifiques sur GPU AMD, sur l'infrastructure CI de Debian.
Des outils regroupés selon leur pertinence pour le travail ci-dessus — pas une liste générique.
Extraction de biomarqueurs, du stade et des données de traitement à partir de comptes rendus d'oncologie française non structurés. Là où le NLP généraliste échoue et où l'adaptation au domaine commence.
Concevoir des systèmes qui privilégient le niveau le moins opaque satisfaisant les seuils de performance. La conformité à l'AI Act européen comme contrainte de conception, pas comme réflexion après coup.
Direction à long terme : unifier texte clinique, imagerie et génomique dans des modèles capables de raisonner à travers les modalités. L'approche des world models appliquée à la médecine.
Enseignement des mathématiques et de la physique-chimie à une dizaine d'élèves chez Complétude, du primaire jusqu'à la terminale. Rendre des concepts denses accessibles est une compétence de recherche, pas un à-côté.
Des articles plus longs sur les méthodes, les impasses et les décisions derrière le travail ci-dessus.
Un état des lieux des points où les pipelines NER standards échouent sur les comptes rendus d'oncologie français, et ce que ça implique pour la structure de DEMNE.
L'argumentaire pour router les entités à travers des règles puis un transformer affiné avant tout appel à un LLM — et ce que ça coûte de se tromper.